Un equipo de Stanford ha presentado Next-Concept Modeling, una forma de generar texto que no escribe palabra a palabra. Es una buena noticia para la eficiencia de la IA, pero en una conversación por voz la latencia de un voicebot se mide de otra manera.
Escribir palabra a palabra: el cuello de botella
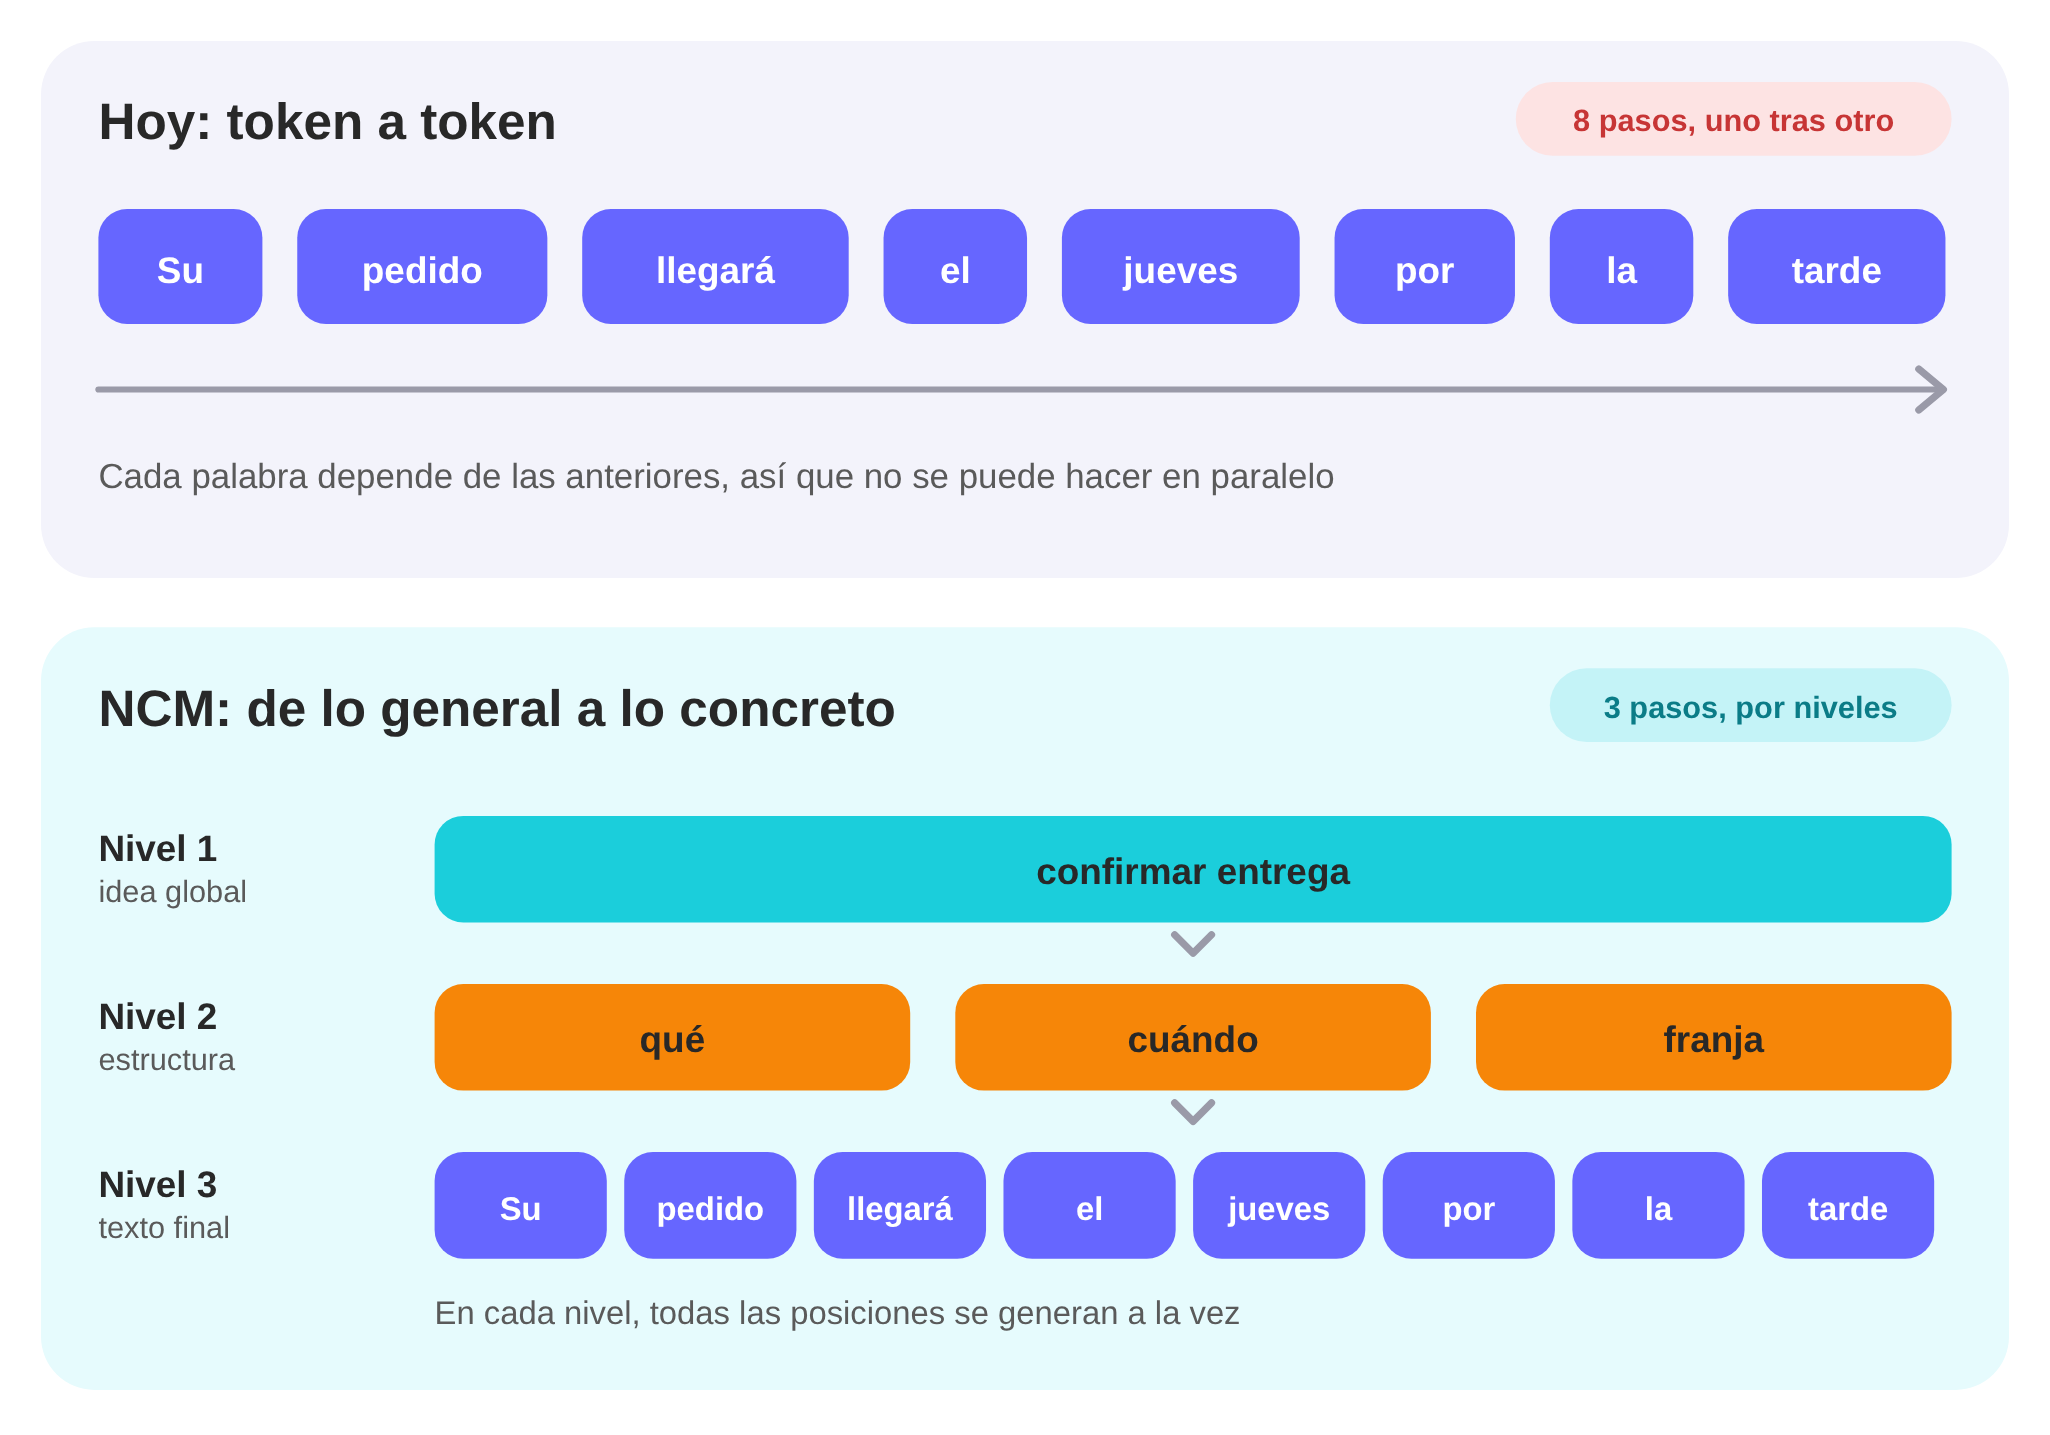
Los grandes modelos de lenguaje que usamos hoy generan sus respuestas de una forma sorprendentemente lineal: una pieza de texto detrás de otra, de izquierda a derecha, y cada una depende de todas las anteriores. Es lo que se conoce como generación autorregresiva o «token a token».
Este mecanismo funciona muy bien, pero tiene un coste evidente: cuanto más larga es la respuesta, más pasos hay que dar, y esos pasos no se pueden hacer en paralelo. Buena parte del esfuerzo de la industria en el último año ha ido a esquivar este cuello de botella, con técnicas que adivinan varias palabras por adelantado o con modelos de difusión que generan el texto completo y lo van puliendo en varias pasadas.
Qué propone NCM
Next-Concept Modeling (NCM), presentado por Hazy Research, el grupo de investigación de Stanford, da un paso diferente. En lugar de escribir la respuesta de principio a fin, primero genera una representación muy general de lo que va a decir y después la va concretando por niveles, hasta llegar al texto final. Dentro de cada nivel, todas las posiciones se generan a la vez.
La consecuencia es importante: el número de pasos ya no depende de la longitud de la respuesta, sino de cuántos niveles de detalle tiene el modelo. Es una idea que ya había dado buenos resultados en generación de imágenes y que ahora se traslada al texto. Los autores han publicado el paper y el código.
Lo que demuestra y lo que todavía no
Los resultados son prometedores: según sus autores, NCM genera texto entre 10 y 31 veces más rápido que los modelos de difusión con los que se compara, con una calidad similar o mejor, y necesita entre 4 y 5 veces menos datos de entrenamiento.
Conviene, sin embargo, leer esos números con calma, como también hacen otros análisis técnicos. La comparación se hace frente a modelos de difusión, no frente a los modelos autorregresivos que se usan en producción. El modelo más grande evaluado tiene 725 millones de parámetros, muy lejos de los modelos comerciales actuales. Y las pruebas no miden capacidades críticas para un asistente real, como seguir instrucciones, consultar sistemas externos o devolver datos estructurados.
| Lo que aporta | Lo que falta por demostrar |
|---|---|
| VelocidadEntre 10 y 31 veces más rápido que los modelos de difusión evaluados. | EscalaFuncionamiento con modelos de miles de millones de parámetros. |
| EficienciaNecesita bastantes menos datos para entrenarse. | Comparación con los LLM actualesNo se mide frente a modelos autorregresivos optimizados. |
| Una idea nuevaEl coste deja de crecer con la longitud de la respuesta. | Capacidades de asistenteInstrucciones, uso de herramientas y salidas estructuradas. |
En resumen, NCM no va a sustituir mañana a los modelos actuales. Lo relevante es la dirección: confirma que la investigación está buscando seriamente alternativas a escribir palabra a palabra, y eso acabará llegando a los productos.
En una llamada, la latencia de un voicebot se mide de otra forma
Aquí es donde el debate se vuelve interesante para quienes trabajamos con IA conversacional por voz. En un voicebot, lo que el usuario percibe no es cuánto tarda el modelo en generar la respuesta completa, sino cuánto silencio hay desde que termina de hablar hasta que el bot empieza a contestar. Esa es la latencia de un voicebot, una idea que ya recogimos entre los retos de un voicebot y entre las predicciones para la voz y la IA en 2026.
Paradójicamente, la generación token a token tiene ventaja en este punto. Como el texto sale en orden, el sistema de síntesis de voz puede empezar a hablar en cuanto está lista la primera frase, mientras el modelo sigue escribiendo el resto. La conversación fluye aunque la respuesta completa aún no exista, algo que ya veíamos al analizar los modelos realtime de OpenAI.
Un modelo que genera por niveles funciona al revés: construye toda la respuesta a la vez y solo tiene texto definitivo al terminar el último nivel. Puede acabar antes, pero no tiene una primera frase que adelantar. Generar más rápido no siempre significa contestar antes.
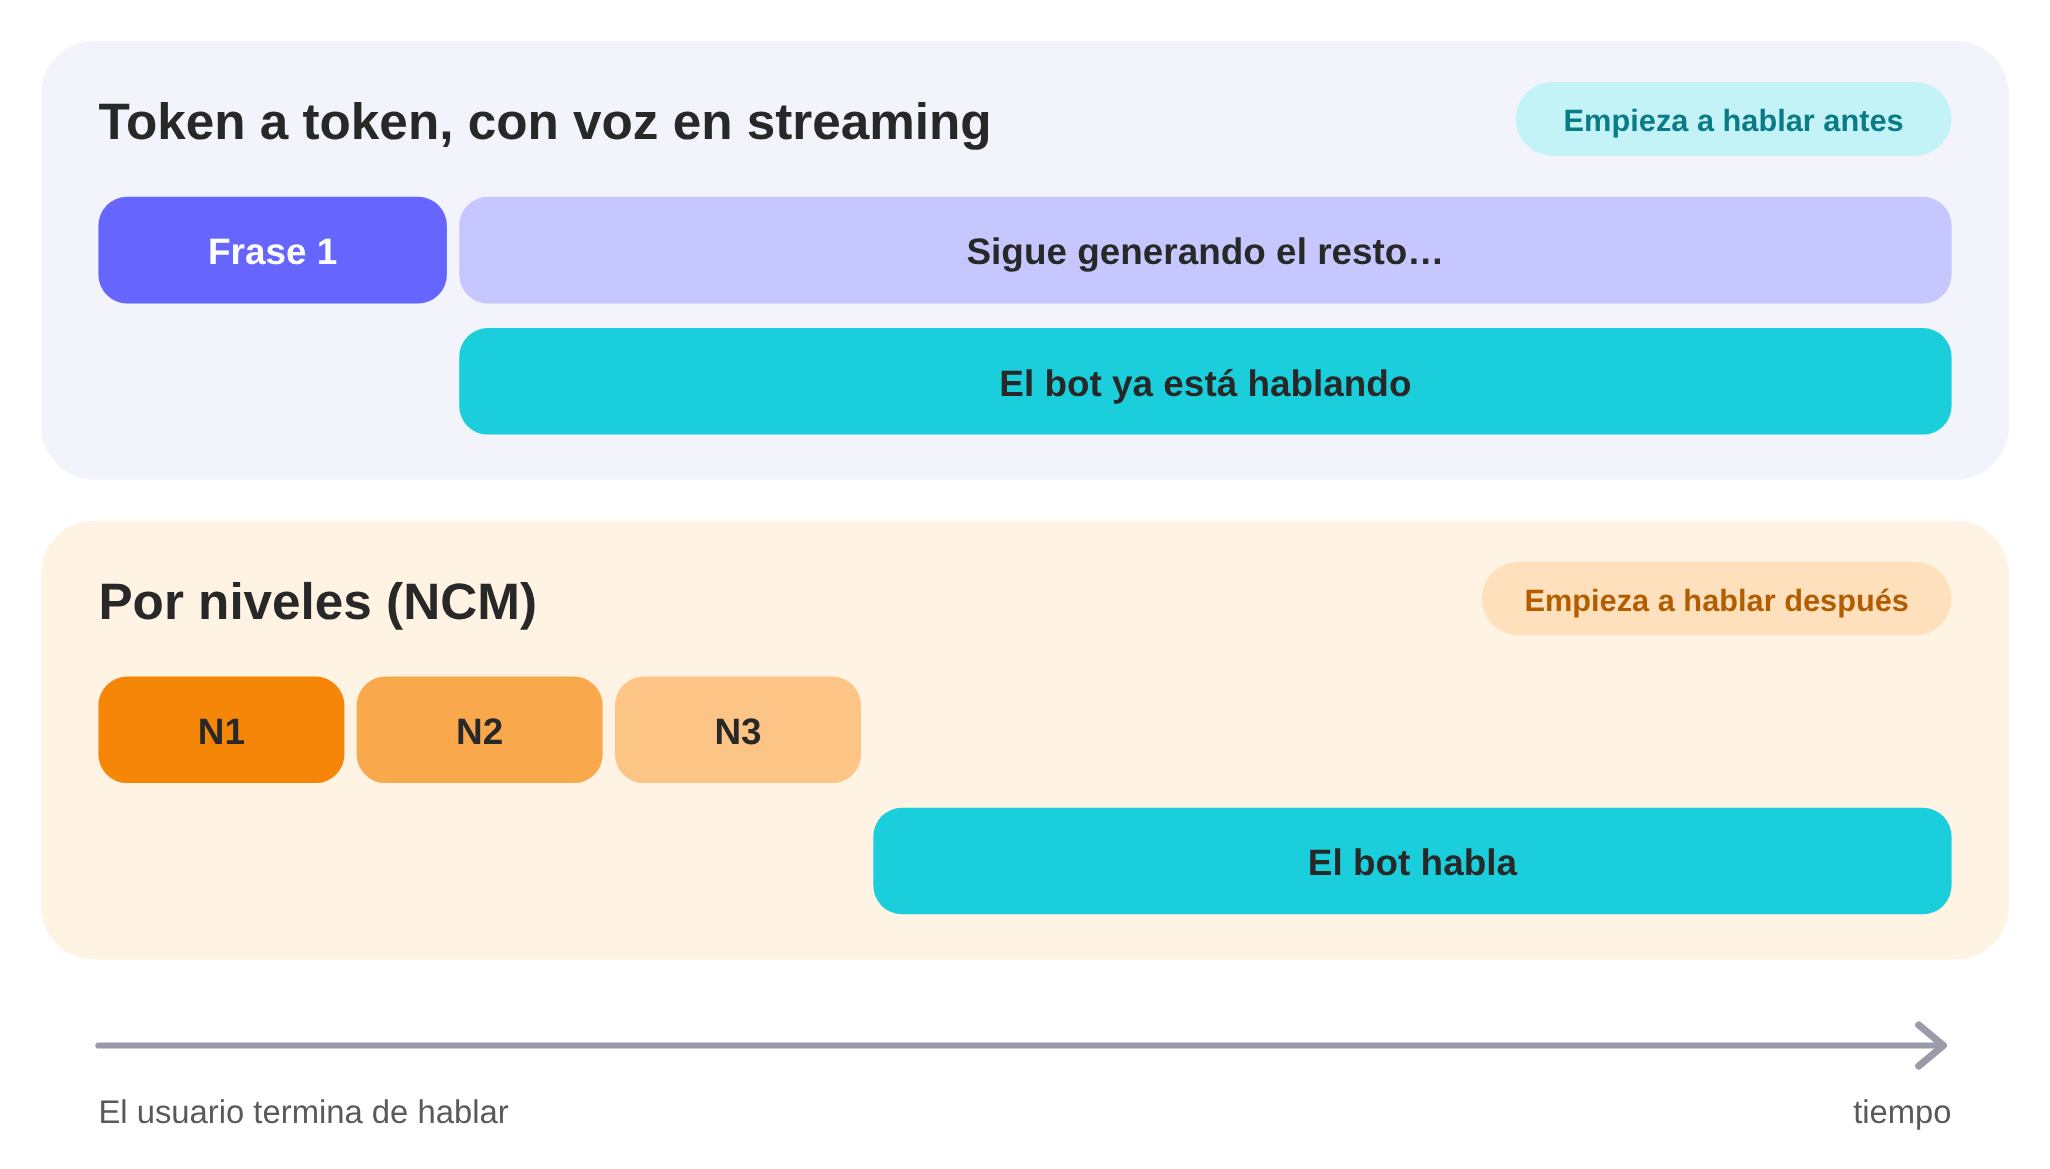
Esto no descarta estas arquitecturas para la voz. Abre preguntas de diseño: respuestas breves que se generen en un único paso, sistemas híbridos que combinen ambos enfoques o modelos que usen menos niveles cuando la pregunta es sencilla. Pero sí demuestra que una mejora en un benchmark no se traduce automáticamente en una mejor experiencia al teléfono.
Cómo medimos en Faktoria la latencia de un voicebot y las nuevas arquitecturas
En Faktoria seguimos de cerca estas investigaciones porque la velocidad, el coste y la calidad de los modelos determinan lo que podemos ofrecer en voicebots, transcripción y analítica conversacional. Pero las evaluamos con criterios de producción, no de titular:
- Latencia percibida: cuánto espera el usuario antes de oír la respuesta, no solo cuánto tarda el modelo.
- Fiabilidad: si sigue instrucciones, respeta el guion y no inventa información.
- Integración: si puede consultar sistemas del cliente y devolver datos estructurados de forma consistente.
- Coste e infraestructura: qué requiere para funcionar y si es viable en el entorno del cliente.
- Gobernanza: si podemos explicar, controlar y supervisar su comportamiento, algo que abordamos desde la gobernanza de la IA.
La próxima generación de modelos de lenguaje probablemente no escribirá como los de hoy. Cuando llegue, la pregunta no será solo cuánto más rápida es, sino si hace que la conversación sea mejor para quien está al otro lado de la línea.
¿Estás evaluando un voicebot o un asistente con IA para tu atención al cliente? Hablemos de cómo medir lo que de verdad importa.